markitdown no te ahorra tokens de Claude en un PDF de diseño: lo que sí funciona
En un brochure de 23 páginas, markitdown ahorró un 35 % de tokens porque no miró las imágenes. Cómo ve Claude un PDF, cuánto cuesta cada imagen y cómo gastar menos sin dejar de mirar.
This post is only available in Spanish.
Resumen
Conclusiones
- No todo lo que se hace viral ahorra tokens. markitdown, la librería de Microsoft que se recomienda para «gastar menos» al pasarle documentos a Claude, ahorró un 35 % en un brochure de 23 páginas. Lo ahorró porque no miró las imágenes, que eran justo lo que hacía falta.
- En un PDF, markitdown no hace más que sacar la capa de texto, lo mismo que una línea de PyMuPDF, y la entrega desordenada.
- Lo que de verdad ahorra es mirar más barato, no dejar de mirar: el texto del PDF para las palabras exactas, la imagen de la página para todo lo demás y miniaturas cuando hay muchas imágenes.
Lo clave
- El brochure completo: con Claude mirando las páginas, 97 mil tokens y todo el contenido. Con markitdown, 63 mil tokens, y faltaron el nombre del edificio (estaba en curvas), las calles del mapa y cualquier rastro de fotos o planos.
- Si después hay que mirar igual, el «ahorro» suma 160 mil tokens frente a 97 mil.
- Una imagen cuesta unos ancho × alto / 750 tokens. Una página de 1365 × 910 son unos 1.650.
- Hojas de contacto: 62 imágenes en 6 hojas de 12 miniaturas, unos 12 mil tokens. Una por una serían unos 100 mil (cálculo con la fórmula, no medido).
- La visión se equivoca con seguridad: leyó «MAGISTRAL DELUXE» donde un render decía «MAGISTRAA».
Recomendaciones
- Para PDFs de diseño, saca con PyMuPDF el texto y una imagen de cada página, y que Claude use las dos cosas.
- Para muchas imágenes, hojas de contacto de miniaturas numeradas, y zoom solo donde haya texto.
- Elimina los duplicados antes de mirar: el hash encuentra las copias exactas y la vista, las casi iguales.
- Antes de adoptar un truco para ahorrar tokens, mídelo con tu propio documento y mira qué se perdió.
1. La prueba
Un brochure inmobiliario de 23 páginas (Magistral Deluxe) y el mismo pedido de dos formas: un markdown fiel, página por página, con todo el texto que ve un lector.
- A, Claude con sus medios: la capa de texto del PDF con PyMuPDF, más cada página como PNG (110 dpi) mirada por Claude. Para lo chico, recortes a 300 dpi.
- B, markitdown 0.1.8 (conversor por defecto, sin plugins ni Azure): Claude solo podía ordenar lo que salía.
Cada caso corrió en un agente aparte, con el mismo modelo y al mismo tiempo, para medir tokens y tiempo por separado.
- Tokens: A, 97,1 mil; B, 62,7 mil.
- Tiempo: A, 2 min 1 s; B, 2 min 42 s.
- Texto de los párrafos y las listas: completo en los dos.
- Texto dentro de imágenes o en curvas, mayúsculas como se imprimen, fotos y planos descritos: solo A.
- Calles del mapa: A las leyó; B las dio letra por letra.
markitdown solo tarda 2,6 s, pero no marca de qué página viene cada trozo, y ordenar su salida se come el resto del tiempo.
2. Lo que se pierde, lado a lado
Arriba, el recorte del PDF. Abajo, lo que sacó cada método, sin tocar.
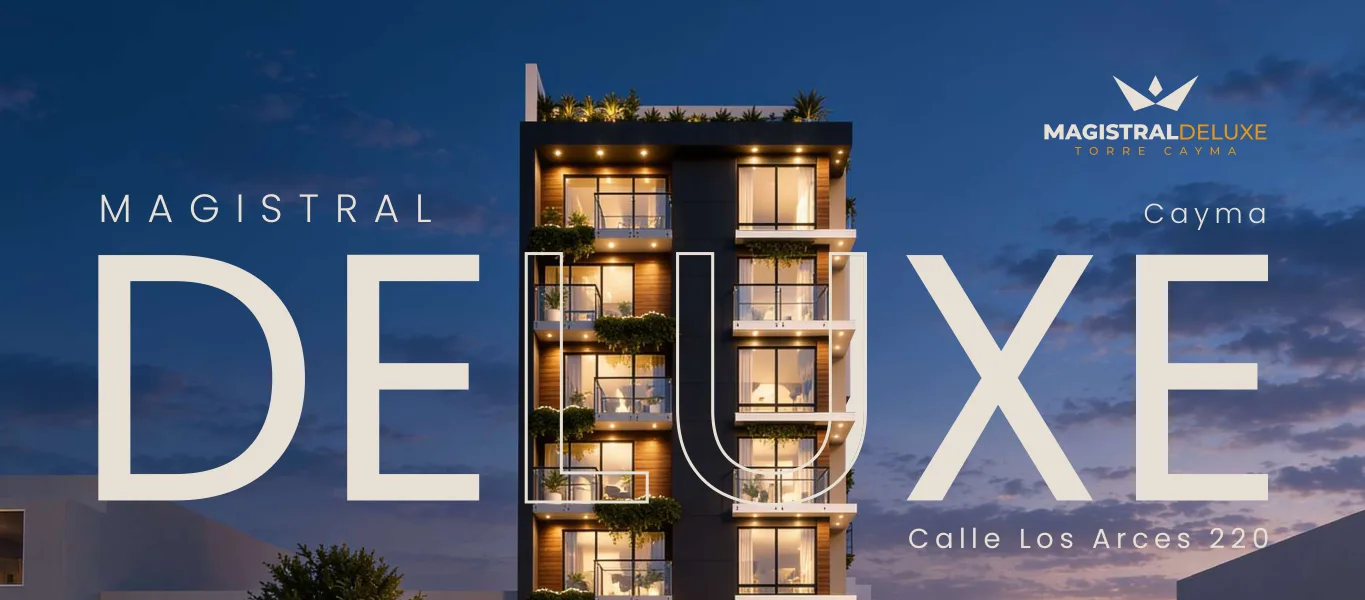
[Logo: corona] MAGISTRAL DELUXE
TORRE CAYMA

# MAGISTRAL DELUXE

Cayma
Calle Los Arces 220

[Render: fachada nocturna del edificio
de 7 pisos, con balcones iluminados
y jardineras]
| M A | G I S | T R A | L   | ...
| --- | ----- | ----- | --- | ...
|     |       |       |     | ... | C       | a y m a     |
|     |       |       |     | ... |   A r c | e s   2 2 0 |
selaicnerefer senegámI*
«DELUXE» y «TORRE CAYMA» no son texto: son curvas. markitdown solo encuentra «MAGISTRAL», partido en una tabla que no existe, y una nota escrita al revés. Sin mirar, ni siquiera sabría cómo se llama el edificio.
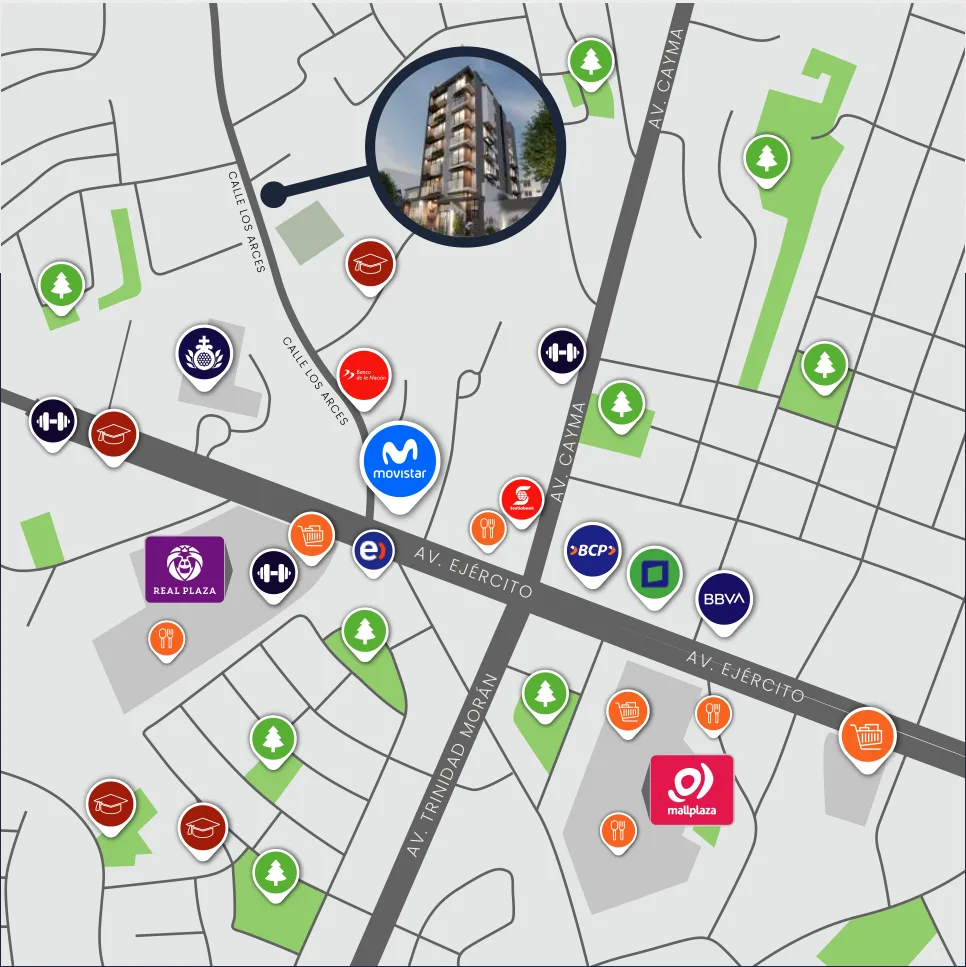
[Mapa: ubicación del edificio en
Calle Los Arces, con íconos de
colegios, gimnasios, bancos,
comercios, restaurantes y parques]

Calles: CALLE LOS ARCES, AV. CAYMA,
AV. EJÉRCITO, AV. TRINIDAD MORÁN

Logos: Banco de la Nación, movistar,
Scotiabank, BCP, BBVA, Entel,
REAL PLAZA, mallplaza
Y
A
C
V.
A
C
A
LLE LO
...
|  | In t er | bank | Á   |
| M o | v is tar |   | R   |
O
...
A
D
NI
...
RI
T
Las calles en diagonal salen letra por letra y mezcladas con la lista de bancos. «AV. TRINIDAD MORÁN» aparece al revés y en pedazos (N, Á, R, O, M, D, A, D, NI, RI, T). Reconstruirla es adivinar.
Las mayúsculas también fallan: markitdown copia cómo está guardado el texto, no cómo se ve, y entrega «CAYMa» y «CONversemos».
3. Por qué markitdown no ahorra en un PDF de diseño
- En PDF es solo un extractor de la capa de texto (pdfminer) con formato.
pymupdf.get_text()da el mismo texto, sin tablas falsas. - Su ahorro viene de no mirar. La diferencia entre A y B, unos 34 mil tokens, es casi lo mismo que cuestan las 23 páginas como imagen (unos 38 mil).
- Si el documento tiene contenido visual, igual hay que mirarlo. Entonces se pagan los dos: 63 mil más 97 mil.
Donde podría servir es con documentos que son puro texto con estructura, como un Word con tablas, un Excel o un HTML. Eso no se probó.
4. Cómo «ve» Claude un PDF
Claude es un modelo multimodal: no usa un OCR aparte. La imagen viaja a los servidores de Anthropic dentro de la conversación, igual que el texto, y el propio modelo la mira. Por eso entiende que «CAYMA» es un título o que un dibujo es el plano de un departamento.
- Cada imagen cuesta tokens: unos ancho × alto / 750.
- Las imágenes grandes se achican antes de mirarlas. La letra chica necesita un recorte en alta resolución.
- La combinación que gana: las palabras exactas, con tildes y erratas, salen de la capa de texto; el orden, las mayúsculas, lo que está en imágenes y para qué sirve cada imagen salen de mirar la página.
- Lo que mira sale de tu equipo. Cuidado con documentos que tengan datos personales.
5. La visión también se equivoca
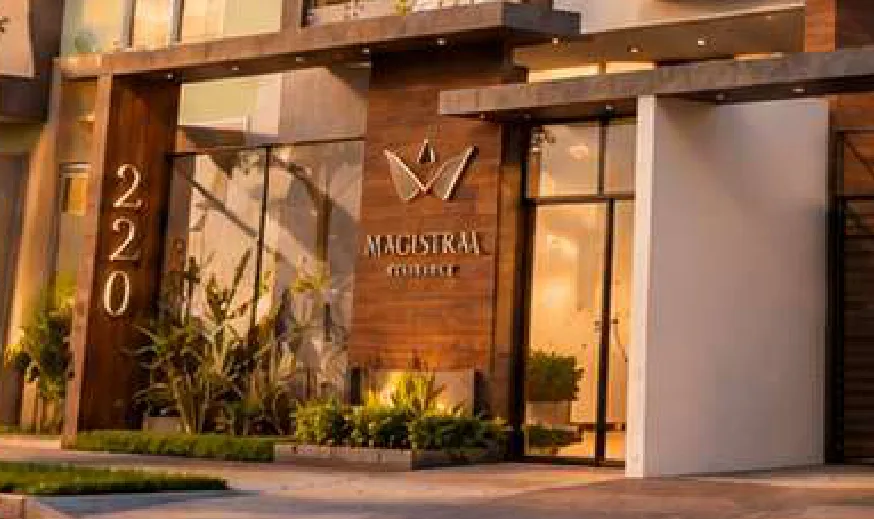
[Render: fachada del edificio al
atardecer; en la entrada se lee
"220" y el logo MAGISTRAL DELUXE]
(nada: el render es una imagen)
Aquí Claude se equivocó: el letrero dice «MAGISTRAA» y debajo hay letras sin sentido, porque el render lo generó una IA. Claude escribió lo que esperaba ver. Mirando de cerca sí se nota, y es un hallazgo valioso: ese render no debería ir a la web sin corregir el logo. markitdown ni se entera de que hay un letrero.
La regla: los datos duros (áreas, metrajes, precios) salen de la capa de texto. Letreros y logos se confirman con un recorte, preguntando «qué letras se ven» y no «qué dice». Y los renders hechos con IA se revisan buscando texto deformado antes de publicarlos.
6. Cómo gastar menos sin dejar de mirar
Probado con las 62 imágenes únicas de la misma entrega:
- Hojas de contacto: 6 hojas de 12 miniaturas numeradas. Son unos 12 mil tokens, frente a unos 100 mil mirándolas una por una. La cifra sale de la fórmula: el contador de la sesión no sirvió para medir imágenes.
- La miniatura basta para clasificar el proyecto, el ambiente, si hay personas y la orientación. El texto siempre pide zoom.
- Duplicados: el hash encontró una carpeta entera repetida con otro nombre, y la vista encontró dos pares del mismo render exportado dos veces, que el hash no detecta porque cambian los bytes. Hacen falta los dos.
- Lo privado se aparta antes de generar cualquier imagen que vaya a Claude, no después.
Cómo se midió y qué no
- Probado: un brochure de 23 páginas, una vez con cada método, en agentes separados con el mismo modelo; y hojas de contacto con 62 imágenes.
- No probado: markitdown con Word, Excel, PowerPoint o HTML, con plugins o con Azure Document Intelligence; otros PDFs.
- Calculado, no medido: el coste de las hojas de contacto y los 160 mil del caso «markitdown y después mirar».